Kafka 分区日志的文件组织方
简介
本文记录 Kafka 分区日志的文件组织方式,以及 RecordBatch 和 Record 的结构。通过梳理 log、index 和 timeindex 文件,整理按 offset 与时间戳查找消息的流程。
文件格式
一个Parition被划分成多个LogSegment,LogSegment名称是第一个消息的id,最后一个支持追加写
Partition ├── Segment 0 ├── Segment 1 ├── Segment 2 └── Active Segment
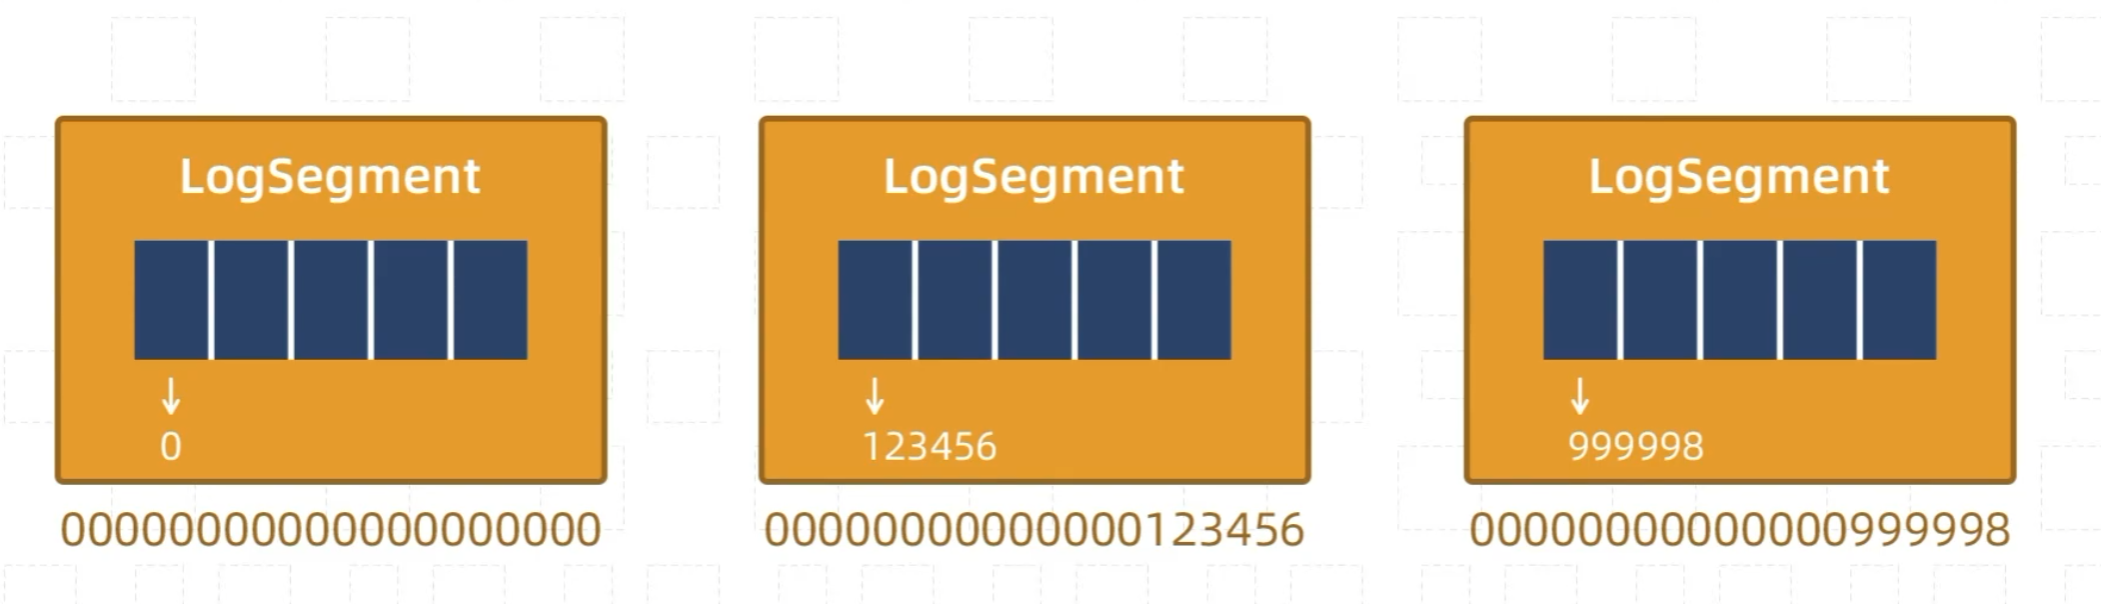
LogSegment 目录 ├── .log文件:存储数据 ├── .index文件:加速根据offset查询 └── .timeindex文件:加速时间戳查询offset
log文件
保存消息批次的列表,kafka底层是采用一个 RecirdBatch 消息作为基本的单位,最大1GB
RecirdBatch
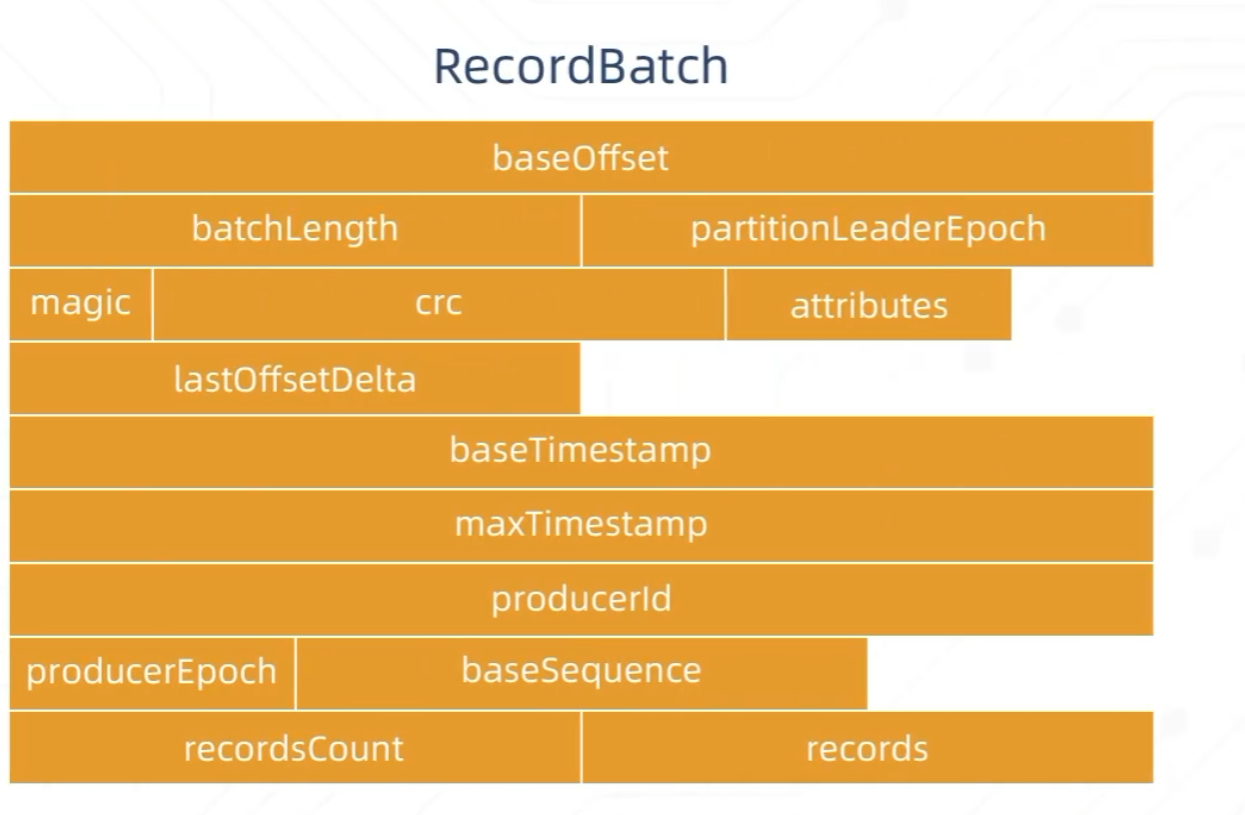
baseOffset:第一条消息的offset
partitionLeaderEpoch:和高可用相关
magic:字节序列版本
arributes:标记位,压缩类型 ,事务消息
lastOffsetDelta:最后一条和第一条差值
baseTimestamp:第一条消息时间戳
recordsCount:recordBatch包含的消息数量
records:消息列表数据
Record单条消息的结构
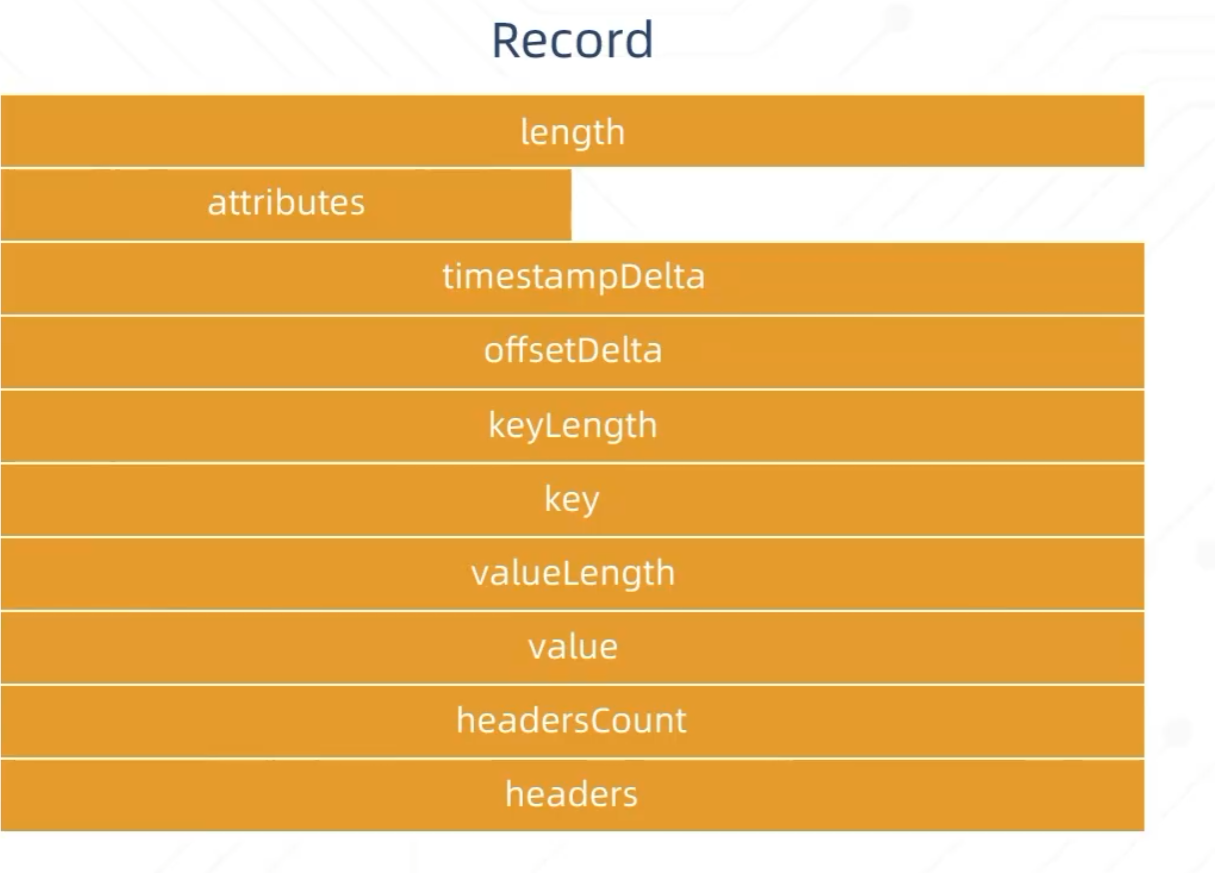
timestampDelta:本消息的时间戳与同batch第一条的差值
offsetDelta:本消息的offset与同batch第一条的差值
headersCount:消息包含header条目数量
headers:header条目列表
index文件
offset到文件物理偏移的映射,多个条目映射构成的列表
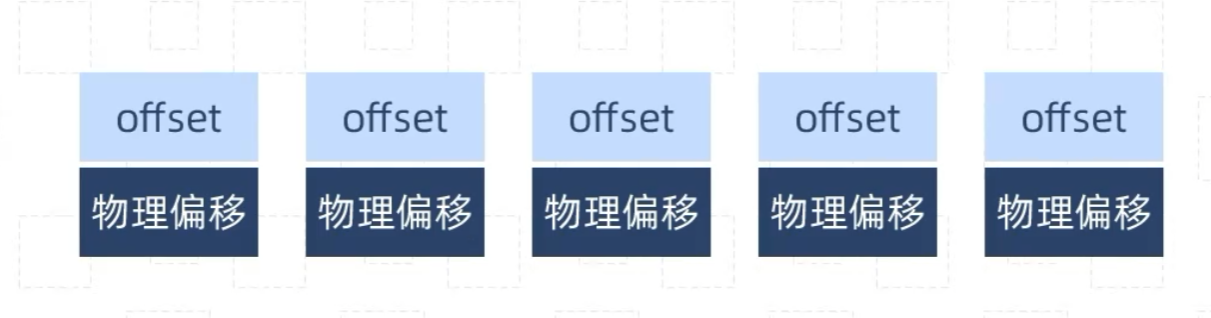
根据offset查找记录
- 根据offset确定 LogSegment目录
- LogSegment目录中的index文件,通过二分查找比较offset,找到最近的条目
- 根据找到条目的从物理偏移开始向后扫描
timeindex文件
时间戳 到文件 offset的映射,多个条目映射构成的列表
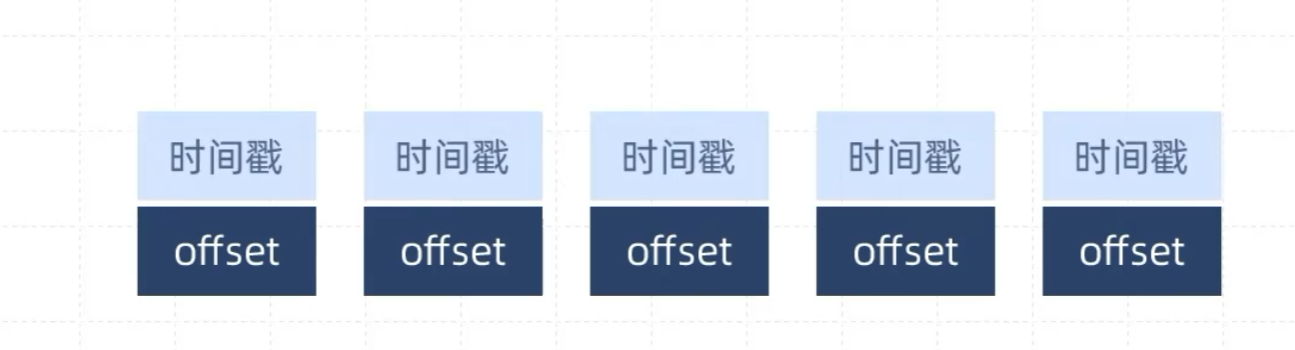
根据时间戳查找记录
- 根据 时间戳 确定 LogSegment目录
- LogSegment目录中的timestampindex文件,通过时间戳找到最近的条目的offset
- 根据offset去 **index **文件找
日志清理
kafka扮演增量数据同步,历史数据一般不重要,一般采用前两种
Time-Based
消息过期时间来删除
以logSegment为粒度进行删除
检查logSegment 最大时间戳
Size-Based
以 partition 大小来删除
Key-Based
如果再kafka中维护完整数据集,例如状态变更流程,下游可以构建完整的流程,
- 可以只针对同一个key,仅保留最新的记录
- 也可以把最新记录设置成null,表示删除所有,不做保留(墓碑标记)
问题
- 过于频繁的compact占资源,影响消费和生产;
- 支持计算partition的dirty占比,超过阈值才compact
- 下游错过消息,如果墓碑标记再下游消费前触发了删除,那么下游就不会删除,为此下游预留一定过期时间,仅对过期的日志执行compact
- 过于慢的compact有问题
- 指定存在时间,如果某些日志超过了生存时间,直接compact
高性能
顺序IO
Partition只追加,不修改,消息过期也是以logSegment为单位整个删除,不会部分更新
缓存
短时间的读写集中在队列尾部,内存局部性原理,有操作系统的缓存
不进行应用层缓存,降低了JVM内存消耗,避免因为缓存导致GC过长
刷盘
积累到一定大小才刷盘,丢数据也不怕,有副本机制
零拷贝
正常生产者发送数据到服务端,以及从服务端拉取数据,是不需要处理的,这样浪费了2次内核到用户态的切换和数据库的拷贝
正常模式模拟read write 把数据发送到网络
┌─────────────────────────────────────────────────────────────────────────────┐
│                               用户空间                                      │
│                                                                             │
│                 ┌──────────┐                                ┌──────────┐    │
│                 │          │ ─────▶ ----------------─────▶ │          │    │
│                 └────▲─────┘                                └────┬─────┘    │
│                      │                                           │          │
│                      │                                           │          │
├──────────────────────┼───────────────────────────────────────────┼──────────┤
│                      │                                           ▼          │
│                               内核空间                                       │
│                      │                                      ┌──────────┐    │
│                 ┌────┴─────┐                                │          │    │
│                 │          │                                └────┬─────┘    │
│                 └────▲─────┘                                     │          │
│                      │                                           │          │
├──────────────────────┼───────────────────────────────────────────┼──────────┤
│                      │                                           ▼          │
│                 ┌──────────┐                               ┌──────────┐     │
│                 │   磁盘   │                               │   网络   │     │
│                 └──────────┘                               └──────────┘     │
└─────────────────────────────────────────────────────────────────────────────┘
零拷贝,直接从内核到网络,不需要经过用户态的切换
┌─────────────────────────────────────────────────────────────────────────────┐
│                               用户空间                                       │
│                                                             				  │
│                                                             				  │
│                                                                             │
│                                                                             │
├─────────────────────────────────────────────────────────────────────────────┤
│                               内核空间                                       │
│                                                                             │
│                 ┌──────────────┐      ┌──────────────┐                      │
│                 │ 文件缓冲区   │ ───▶ │ Socket缓冲区   │                      │
│                 └──────▲───────┘      └──────┬───────┘                      │
│                        │                     │                              │
├────────────────────────┼─────────────────────┼──────────────────────────────┤
│                        │                     ▼                              │
│                 ┌──────────┐          ┌──────────┐                          │
│                 │   磁盘   │           │   网络   │                          │
│                 └──────────┘          └──────────┘                          │
└─────────────────────────────────────────────────────────────────────────────┘
分层存储
kafka扩容加broker,会浪费多余的cpu和内存; 新broker加入集群需要长时间的副本同步,节点同步
分层存储数据解决要保存数据量过大的引发的问题
解决思路
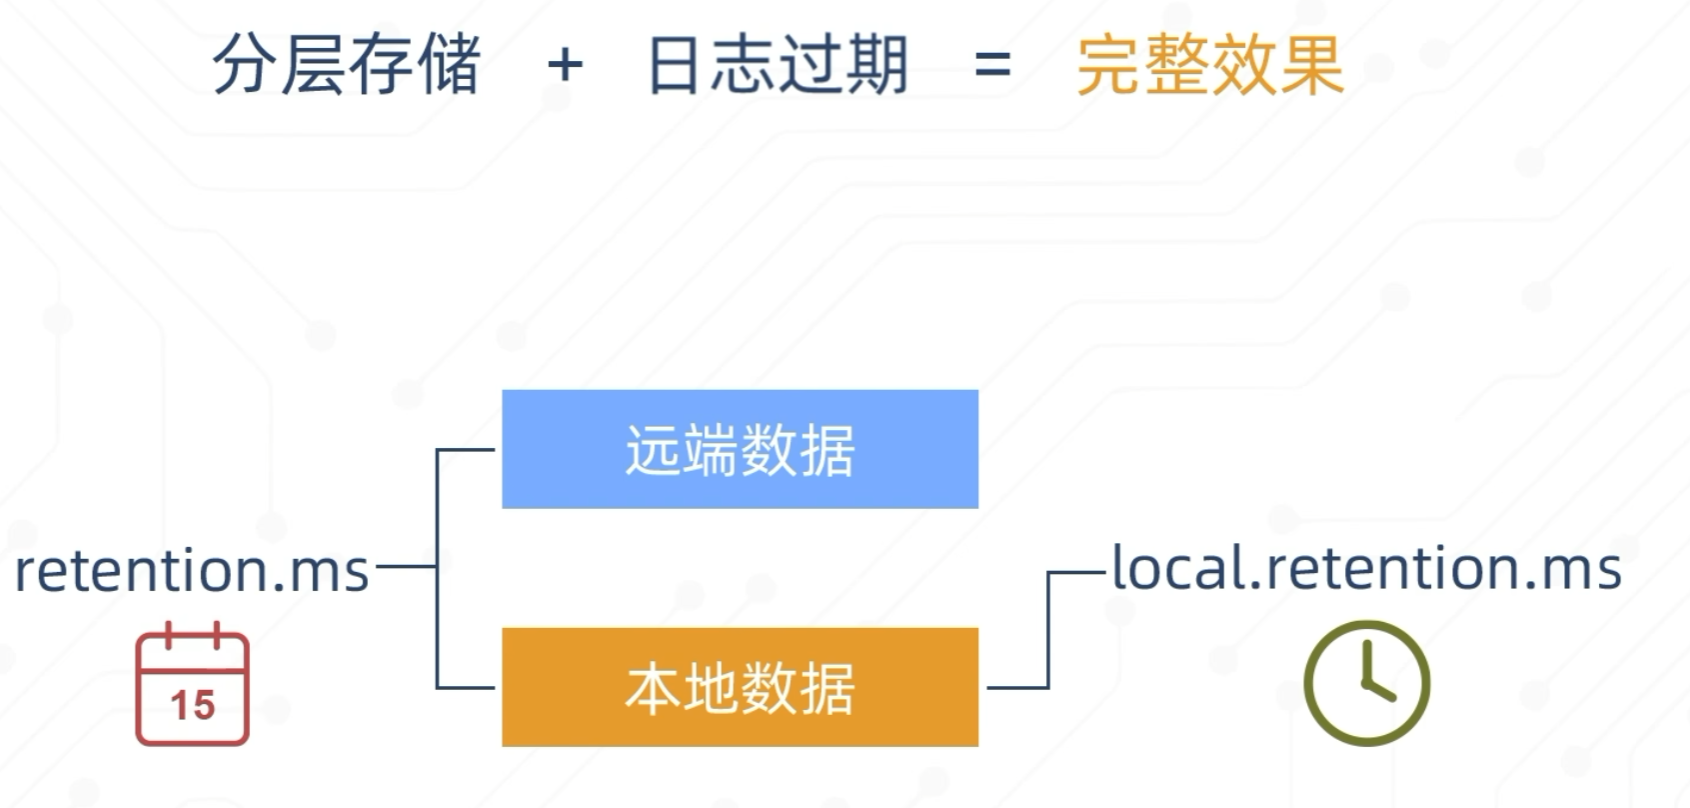
#远程整体过期时间
retention.ms = 7天
#本地数据的过期时间
local.retention.ms = 1小时
以logsegment位单位,本地只存储最近过期时间内的热数据,远程存储整体过期时间内冷数据
消费者读取
本地优先,根据请求的offset先去本地数据查询,没有再去远端查询
Follower复制
follower只复制leader本地的消息和leader达成一直
缺点
- 冷数据在远端,数据更慢,依赖远程的吞吐
- 不支持 compacted topic, 每个key只保留最新一条的清理策略